AI 在制药项目中的角色与证据责任:对象、工具及其交叠
面向制造与质量项目的批判性叙述综述
Roles and Evidence Accountability of Artificial Intelligence in Pharmaceutical Projects: Deliverable, Tool, and Their Overlap
A Critical Narrative Review of Manufacturing and Quality Projects
摘要
Abstract|英文摘要
一、问题的起点:谁为结果负责
二、检索范围与证据判断
三、角色框架的用途与边界
四、实证研究支持到了哪一步
五、从模型评价转向完整工作流
六、人在环需要证明的是监督效果
七、交叠情境中的证据独立性
八、智能体的执行权限必须在系统中落实
九、把监管边界和变更责任写入项目交付
十、差距分析:需要验证的是控制的增量价值
结论
附录:中英术语与缩写速查
参考文献
摘要
人工智能(Artificial Intelligence,AI)既是制药项目要交付的系统,也是做项目的工具。用 AI 验证 AI 系统自身、或管理其变更时,两种身份就叠在一起。制造与质量项目面对的是同一组问题:角色怎样影响责任分配,加上的控制能不能改善实际结果。
证据范围限于截至 2026 年 9 月 20 日的定向检索与引文追溯。监管文件、制药研究、人机协作试验和智能体研究,各有各的证据用途。制药研究支持部分记录抽取、检索和受控辅助任务可行;生成式 AI 能否稳定改善调查质量、总周期和生产结局,证据还不够。
跨领域研究显示,AI 能提高特定写作和客服任务的效率。但有人参与,不保证监督有效;模型评分,也代替不了完整工作流评价。对象、工具与交叠这一视角,可以用来识别证据责任;它是否比现有安排更有用,仍需比较验证。
选控制措施,看四件事:使用情境、质量影响、决策依赖、执行权限。人工复核、独立参考证据、权限限制、变更测试,每一项都要算两笔账:有没有用,费多少事。研究不能停在单次成功,要比较完整流程、查明共同失效,确认什么条件下值得持续使用。定向检索和跨领域外推限制了这些结论。
关键词:人工智能;制药项目管理;证据责任;人机协作;智能体;生命周期治理。
Abstract|英文摘要
Artificial intelligence (AI) can be a pharmaceutical project deliverable or a tool for doing project work. The roles overlap when AI helps validate AI systems or manage their changes. Manufacturing and quality projects face two unresolved questions: how these roles shape accountability, and whether the associated controls improve results.
The evidence base for this critical narrative review comes from targeted searches and citation tracing through 20 September 2026. Regulatory documents, pharmaceutical studies, human–AI experiments, and agent research serve distinct evidentiary roles. The pharmaceutical studies identified support the feasibility of selected extraction, retrieval, and supervised tasks. They do not establish consistent benefits of generative AI for investigation quality, total workflow time, or manufacturing outcomes.
Studies in other domains show productivity gains in writing and customer support. Yet human involvement does not ensure effective oversight, and model scores cannot replace workflow evaluation. The deliverable–tool–overlap framework may help identify evidence responsibilities. Whether it adds value still requires comparative testing.
Controls should reflect context of use, quality impact, decision reliance, and execution permissions. Human review, independent reference evidence, permission boundaries, and change testing need evaluation for both effectiveness and cost. Research should compare complete workflows, identify shared failure mechanisms, and establish when continued use delivers value. Cross-domain transfer and the selective search strategy limit the strength of these conclusions.
Keywords|关键词:Artificial intelligence; pharmaceutical project management; evidence accountability; human–AI collaboration; AI agents; lifecycle governance.
一、问题的起点:谁为结果负责
2026 年 4 月,美国食品药品监督管理局(Food and Drug Administration,FDA)向 Purolea Cosmetics Lab 发出警告信,检查对象是药品生产场所。企业用 AI 智能体编写规格、规程和主生产或控制记录,却没有确保文件准确、符合要求。工艺验证没做,企业的解释是:AI 没有提醒。FDA 要求,若恢复生产并继续用 AI 辅助相关活动,相关输出或建议须经质量部门授权人员审核认可。1
这个案例说明,AI 生成的文件可以进入正式质量活动。但不能据此认定,问题就是"角色混淆"造成的:既有质量体系失效、人员能力不足,也可能解释检查发现。警告信列出的是具体违规和整改要求,没有检验哪种治理框架更有效。
项目管理协会(Project Management Institute,PMI)2026 年 6 月发布《项目组合、项目集与项目管理人工智能标准》(The Standard for Artificial Intelligence in Portfolio, Program, and Project Management)。公开介绍涵盖两件事:在项目中使用 AI,以及管理 AI 驱动的项目。2, 3 建设 AI 的团队和使用 AI 的团队,要回答同一个问题:双方对失败后果的认识是否一致,交出的依据是否足够支持判断。
讨论范围限定在药品制造、质量管理和项目交付。药物发现和临床诊疗的效果不在直接评价范围内;引用临床研究,只为考察人机协作的机制。医疗器械规则也只在边界清楚时用作比较。对象、工具、交叠是一套项目分析视角;它有没有用,要看能否减少责任遗漏、改善可检验的结果。
二、检索范围与证据判断
资料来自公开网页定向检索、官方发布渠道和引文追溯,更新截止 2026 年 9 月 20 日。检索主题包括制药制造与质量、偏差调查、语言模型、人工监督、智能体可靠性和变更管理;检索词及取舍见配套《定向检索记录》。监管资料,回到发布机构原文核对;实证研究,优先取原始论文和能取得的全文;较早的方法学研究,用来解释评价设计。
一份资料能不能进来说话,看它能否回答四个问题:AI 承担什么任务;证据由谁产生、谁确认;控制是否改善了任务或工作流;变化之后,使用依据怎么维持。营销材料、不讲方法的效果宣传、查不到来源的数字,不能当证据用。只能取得摘要或预览的研究,保留访问限制标记;预印本与正式版分开标记,不同版本的样本和结果不拼接。
这是一项批判性叙述综述(Critical Narrative Review)。检索没有覆盖全部订阅数据库,也没有预注册、完整去重筛选和独立双人筛选,不能据此判断某类研究在整个领域中的占比。不同任务、模型和终点不作合并估计。叙述综述质量评估量表(Scale for the Assessment of Narrative Review Articles,SANRA)提供检查目的、检索说明、引用、推理和终点数据的维度;它不是系统综述认证。4
证据分两类用途:监管文件用来看义务、监管关注和适用范围;比较研究用来判断效果。草案有政策权威,试验给因果证据,两者不在同一条等级上。检查个案能暴露失效,利益相关方调查能识别需求,厂商实践能提供工程方案;但这些材料本身,都给不出控制措施的平均效果。
三、角色框架的用途与边界
对象身份(AI as a Deliverable):项目负责建成并交付一套 AI 系统。工具身份(AI as a Tool):AI 参与完成项目里的某项工作。交叠(Overlap):两种身份在同一任务链上相遇,比如用 AI 起草另一套 AI 系统的验证方案。交叠不是互斥的第三类系统,也不是法定风险等级。
先定分析单位。同一套文档助手,在建设项目里是对象,在设备改造项目里是工具;它支持自身或另一套 AI 系统的验收时,才出现这里说的交叠。把单位固定在"任务—决策—责任主体",可以避免给软件贴上永久身份后忽略用途变化。
判定角色,可以从验收边界开始。项目验收包含 AI 系统及其运行配置,系统就是交付对象;采购商业产品再做配置集成,也算。AI 输出被用来完成某项项目任务,它就在这项任务里承担工具角色。这项辅助工作进入 AI 系统的建设、验证或变更管理时,才同时记为交叠。普通设备项目用 AI 写会议纪要,是工具使用——不因为用了 AI,就变成 AI 交付项目。
证据责任要落到人:每项预定决定,谁提供依据、谁核查、谁批准,各自该提交或保留什么材料。角色可以兼任;要不要分离、分到什么程度,看适用制度和风险。把分工列清楚,不等于完成了独立验证。
表 1|角色、证据责任与不能由角色推出的结论。概念性分析,尚未经比较研究验证。
表 1|角色、证据责任与不能由角色推出的结论。概念性分析,尚未经比较研究验证。
| 角色 | 主要责任问题 | 可核查的证据 | 不能直接推出的结论 |
|---|---|---|---|
| 对象 | 交付什么,谁判定适合使用 | 预定用途、系统范围、验收准则、运行与退出安排 | 模型演示成功等于系统可投入质量活动 |
| 工具 | 输出如何影响项目决定,谁承担后果 | 来源、结果核验、实际采用方式、收益和返工 | 仅称“辅助工具”就不需要质量控制 |
| 交叠 | 生成与评价是否共享同一盲点 | 独立参考依据、测试集来源、审核判断及其权限 | 多个 AI 互相同意就构成独立验证 |
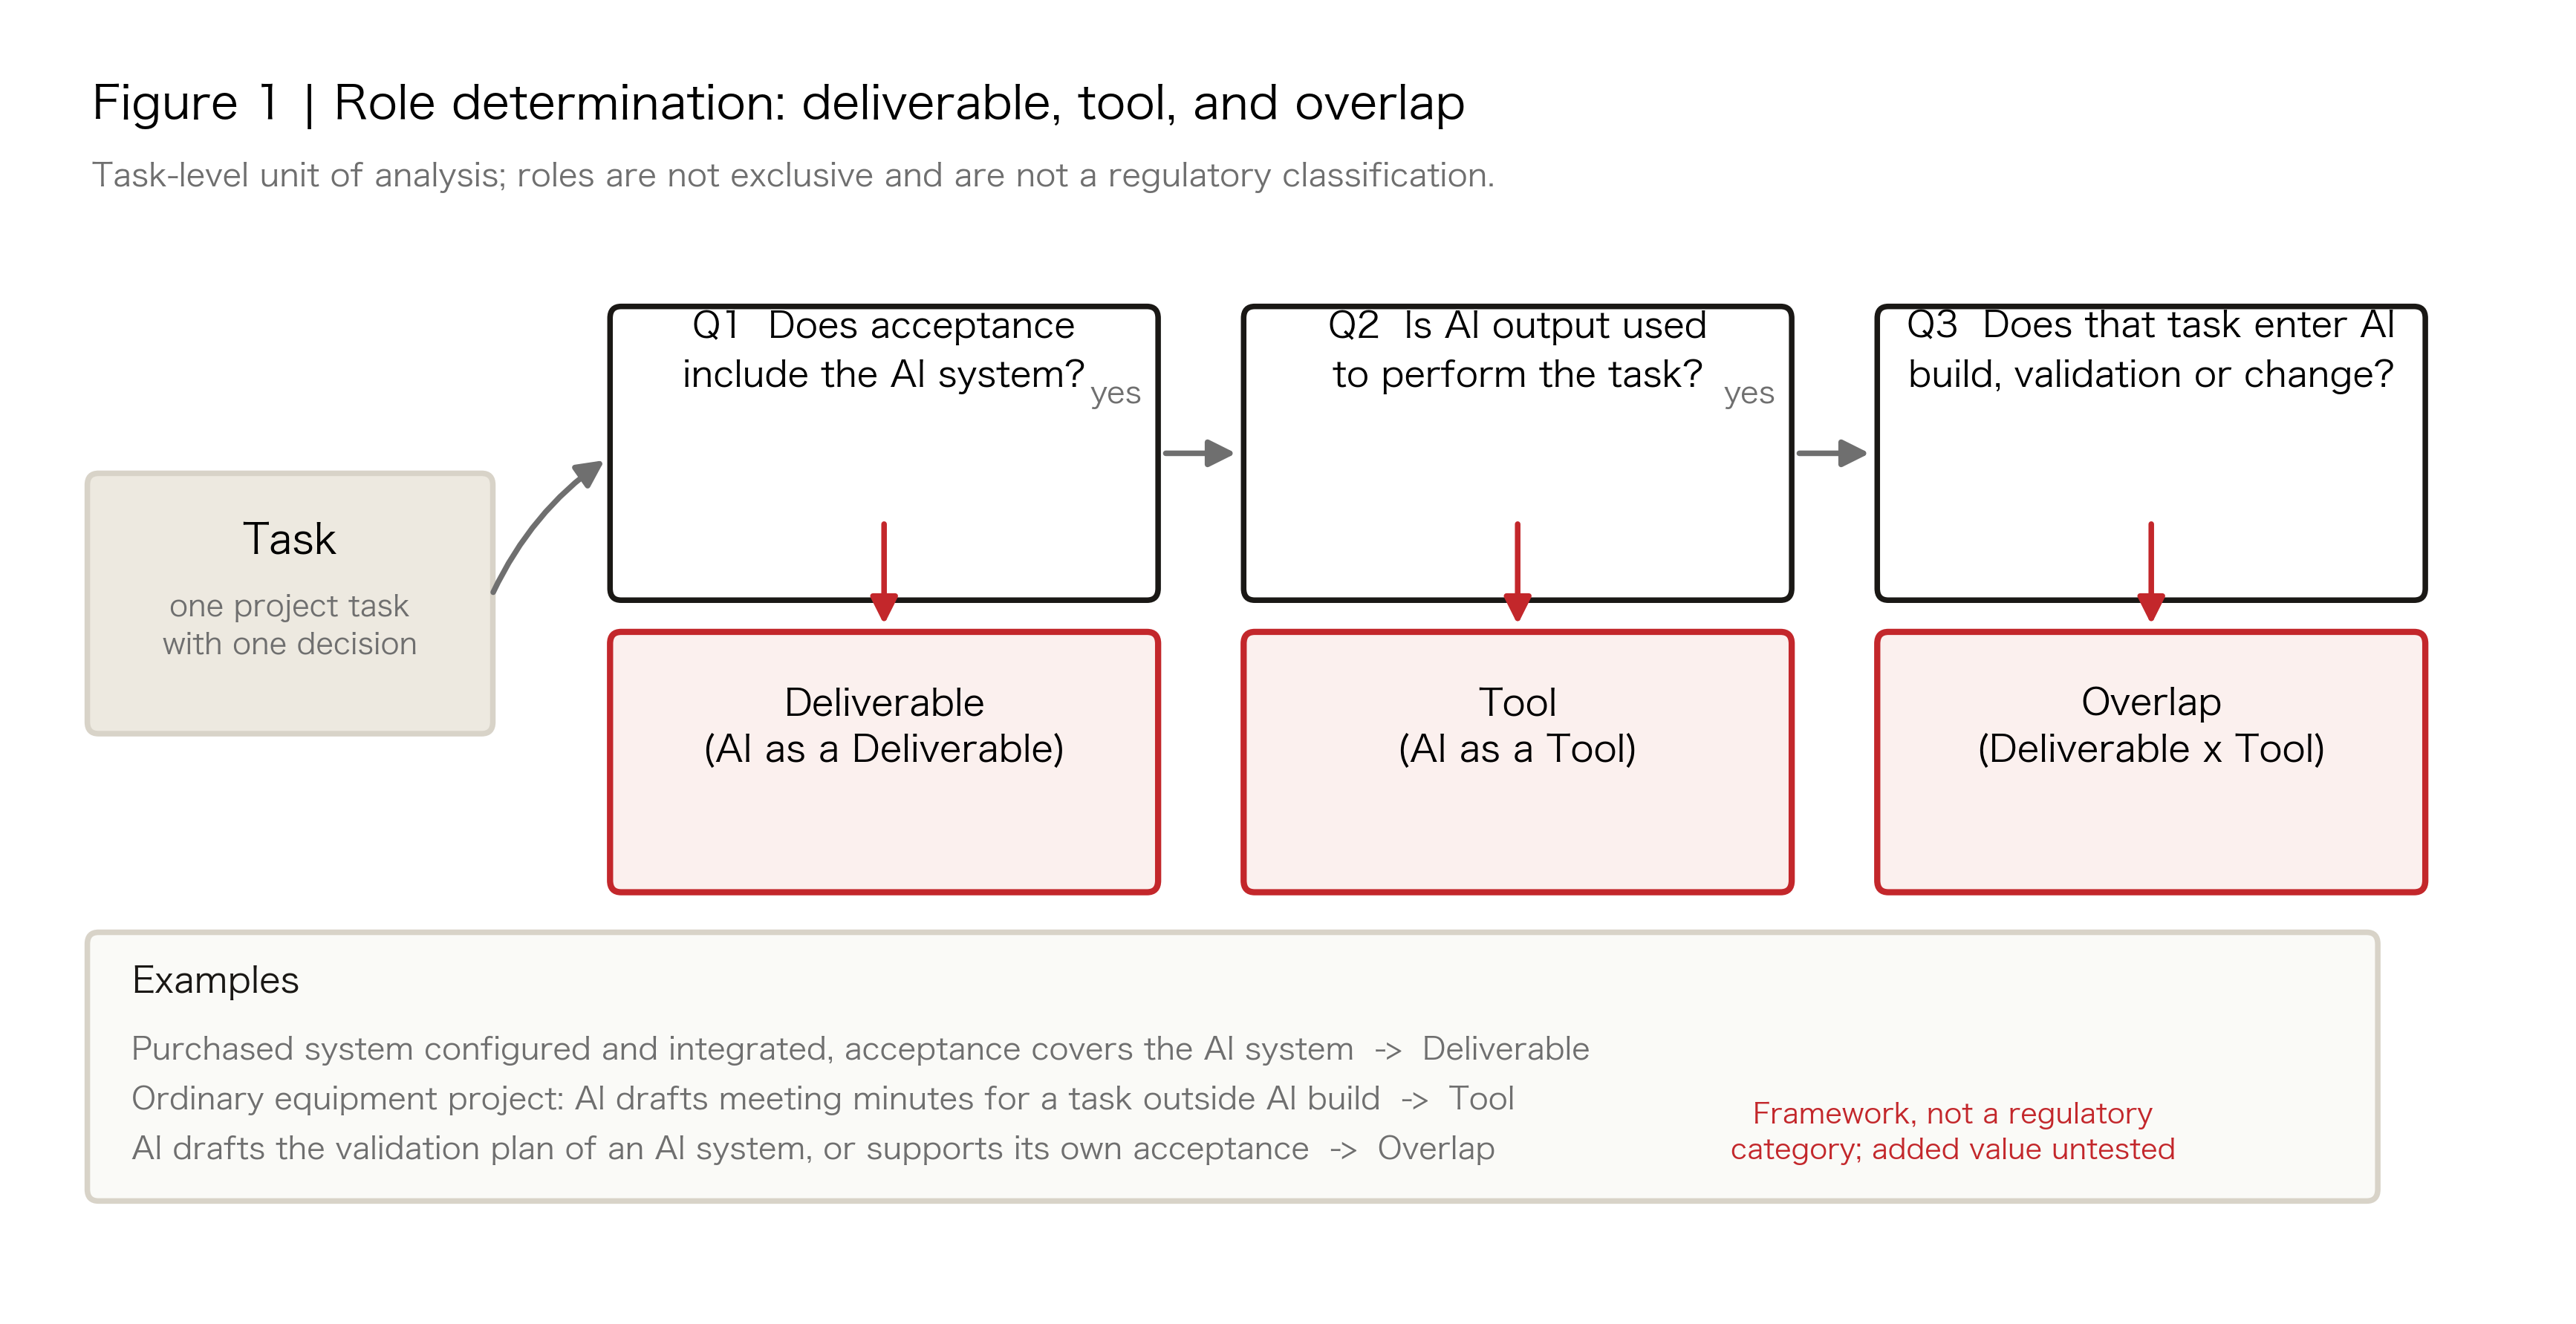
AI 为非 AI 项目起草生产规程,一样要管来源、审核和记录。交叠情境把"生成与评价共享盲点"的问题,直接带进了 AI 验证流程。这种共同失效(Common-Cause Failure)不是交叠独有;角色框架能不能减少由此产生的责任遗漏,仍需比较验证。
实际控制仍取决于使用情境(Context of Use,COU)。FDA 2025 年的相关草案,把药品监管决策中的模型可信度与具体使用情境挂钩;该文件仍是草案,也不覆盖所有企业办公用途。5 一份会议纪要,和一份影响批次处置的建议,即使出自同一模型,所需证据也不同。角色框架补的是责任视角,不能代替质量风险评估。
四、实证研究支持到了哪一步
直接面向制药的研究,首先支持的是任务可行性。Salami 等的正式论文考察了偏差报告的知识抽取和相似事件识别。6 能取得全文的早期预印本用了 20 份真实调查报告;被评为"可接受"的根因抽取结果里,包含把促成因素当成根因的情况。7 这类评价说明模型能处理历史文字,证明不了它能正确完成新的调查。20 例数据集在正式版中仍然存在,正式版另列第二套数据;早期样本数不能代表正式版的全部研究。
Amin 的沙箱试点报告了验证周期和审核一致性的改善。8 但它用的是语义匹配、梯度提升等方法,不能据此判断生成式语言模型的效果。评价细节报告不充分,数据无法公开复核;这个结果更适合当作进一步试验的依据。
收益证据要看跨领域研究。Noy 与 Zhang 的随机实验纳入 453 名专业人员:指定写作任务平均用时减少 40%,质量评分提高 18%。9 Brynjolfsson 等用 5,172 名客服人员的分阶段上线数据估计,AI 辅助使每小时解决问题数平均提高约 15%。10 一个研究短时写作,一个是单一企业的准实验。它们支持特定条件下的任务收益,还不能直接推出制药质量改善或完整项目回报。
表 2|代表性实证研究及其可支持的判断。研究异质性大,未作合并评价。
表 2|代表性实证研究及其可支持的判断。研究异质性大,未作合并评价。
| 研究与设计 | 样本及主要结果 | 可以支持什么 | 主要限制与外推边界 |
|---|---|---|---|
| Salami 等,制药偏差记录离线研究;2024 预印本、2025 正式版7, 6 | 早期全文为 20 份真实报告,考察信息抽取和相似度;正式版预览显示采用两套数据 | 历史记录抽取与检索具有可行性 | 正式版全文未取得;早期评价未报告独立盲评;未测新调查质量、总耗时或生产结局 |
| Amin,2026,两个沙箱项目的比较试点8 | 约 650 项历史需求、120 条偏差;比较 12 个基线周期与 12 个人机协作周期,作者报告周期缩短 32%(95% 置信区间 25%–38%) | 部分非生成式 AI 辅助验证值得进一步检验 | 审核者及比较方法信息不足;数据声明为不适用;不能推出生产部署效果或监管接受 |
| Vaccaro 等,2024,系统综述与元分析11 | 106 项实验、370 个效应量;人机组合优于单人,标准化效应量 g=0.64(95% 置信区间 0.53–0.74);低于单人与单 AI 中较优者,g=−0.23(−0.39 至 −0.07) | 基线选择会改变“协作是否有效”的结论 | 检索截至 2023 年 6 月;任务异质性高;不能代表当前制药模型 |
| Goh 等,2024,随机临床试验12 | 50 名医师、244 次病例作答;人机组与常规资源组评分中位数 76% 对 74%,模型调整后的组间差为 2 个百分点(95% 置信区间 −4 至 8) | 提供高能力模型未必改善使用者的任务表现 | 模拟病例、小样本;不评价患者结局,也非制药质量任务 |
| Dratsch 等,2023,建议正确性操控实验13 | 27 名放射科医师;最资深组(5 名)在正确和错误伪 AI 建议条件下的平均分级正确率分别为 82.3% 与 45.5% | 专家判断也可能受错误建议影响 | 使用伪 AI 建议,无无 AI 对照;不是部署前后效果比较 |
| Agweyu 等,2026,以临床人员为随机单位的实用性整群随机试验14 | 16 家机构、103 名临床人员;9,691 人入组,9,347 人进入主要分析。AI 组与对照组 14 天治疗失败为 102/4,693(2.2%)与 94/4,654(2.0%);调整比值比 0.77(95% 置信区间 0.55–1.08) | 部分文书指标改善,但主要临床终点未显示统计学显著差异 | 单一城市医疗网络、随访较短;统计上未显著不等于两种流程等效 |
| Noy 与 Zhang,2023,预注册在线随机实验9 | 453 名专业人员;平均用时减少 40%,经同行专业人员盲评的质量评分提高 18% | 某些专业写作任务可同时改善速度与评分 | 20–30 分钟任务,不要求情境专属知识或精确事实核验;18% 是评分相对改善,不是准确率提升 |
| Brynjolfsson 等,2025,分阶段上线的差分比较准实验10 | 5,172 名客服人员、约 300 万次对话;每小时解决问题数平均提高约 15% | AI 辅助可在实际工作环境中提高任务生产率 | 单一企业和职业,主分析非随机;收益异质,不等同企业利润或制药质量收益 |
后六项研究提供的是跨领域的任务收益、协作机制和评价方法;药厂部署仍需直接证据。尤其不能把元分析读成"人机组合普遍不如人",也不能把含无效值的置信区间读成"已经证明无效"。
这些结果提示按任务内容分层,不要给"文档工作"统一估值。整理报告措辞和判断根因是两种能力;同一份偏差报告可能两样都有。专业写作实验的评分改善,不宜移用到事实核验和质量处置上。反过来,人机诊断试验没显示收益,也否定不了语言整理的效率价值。
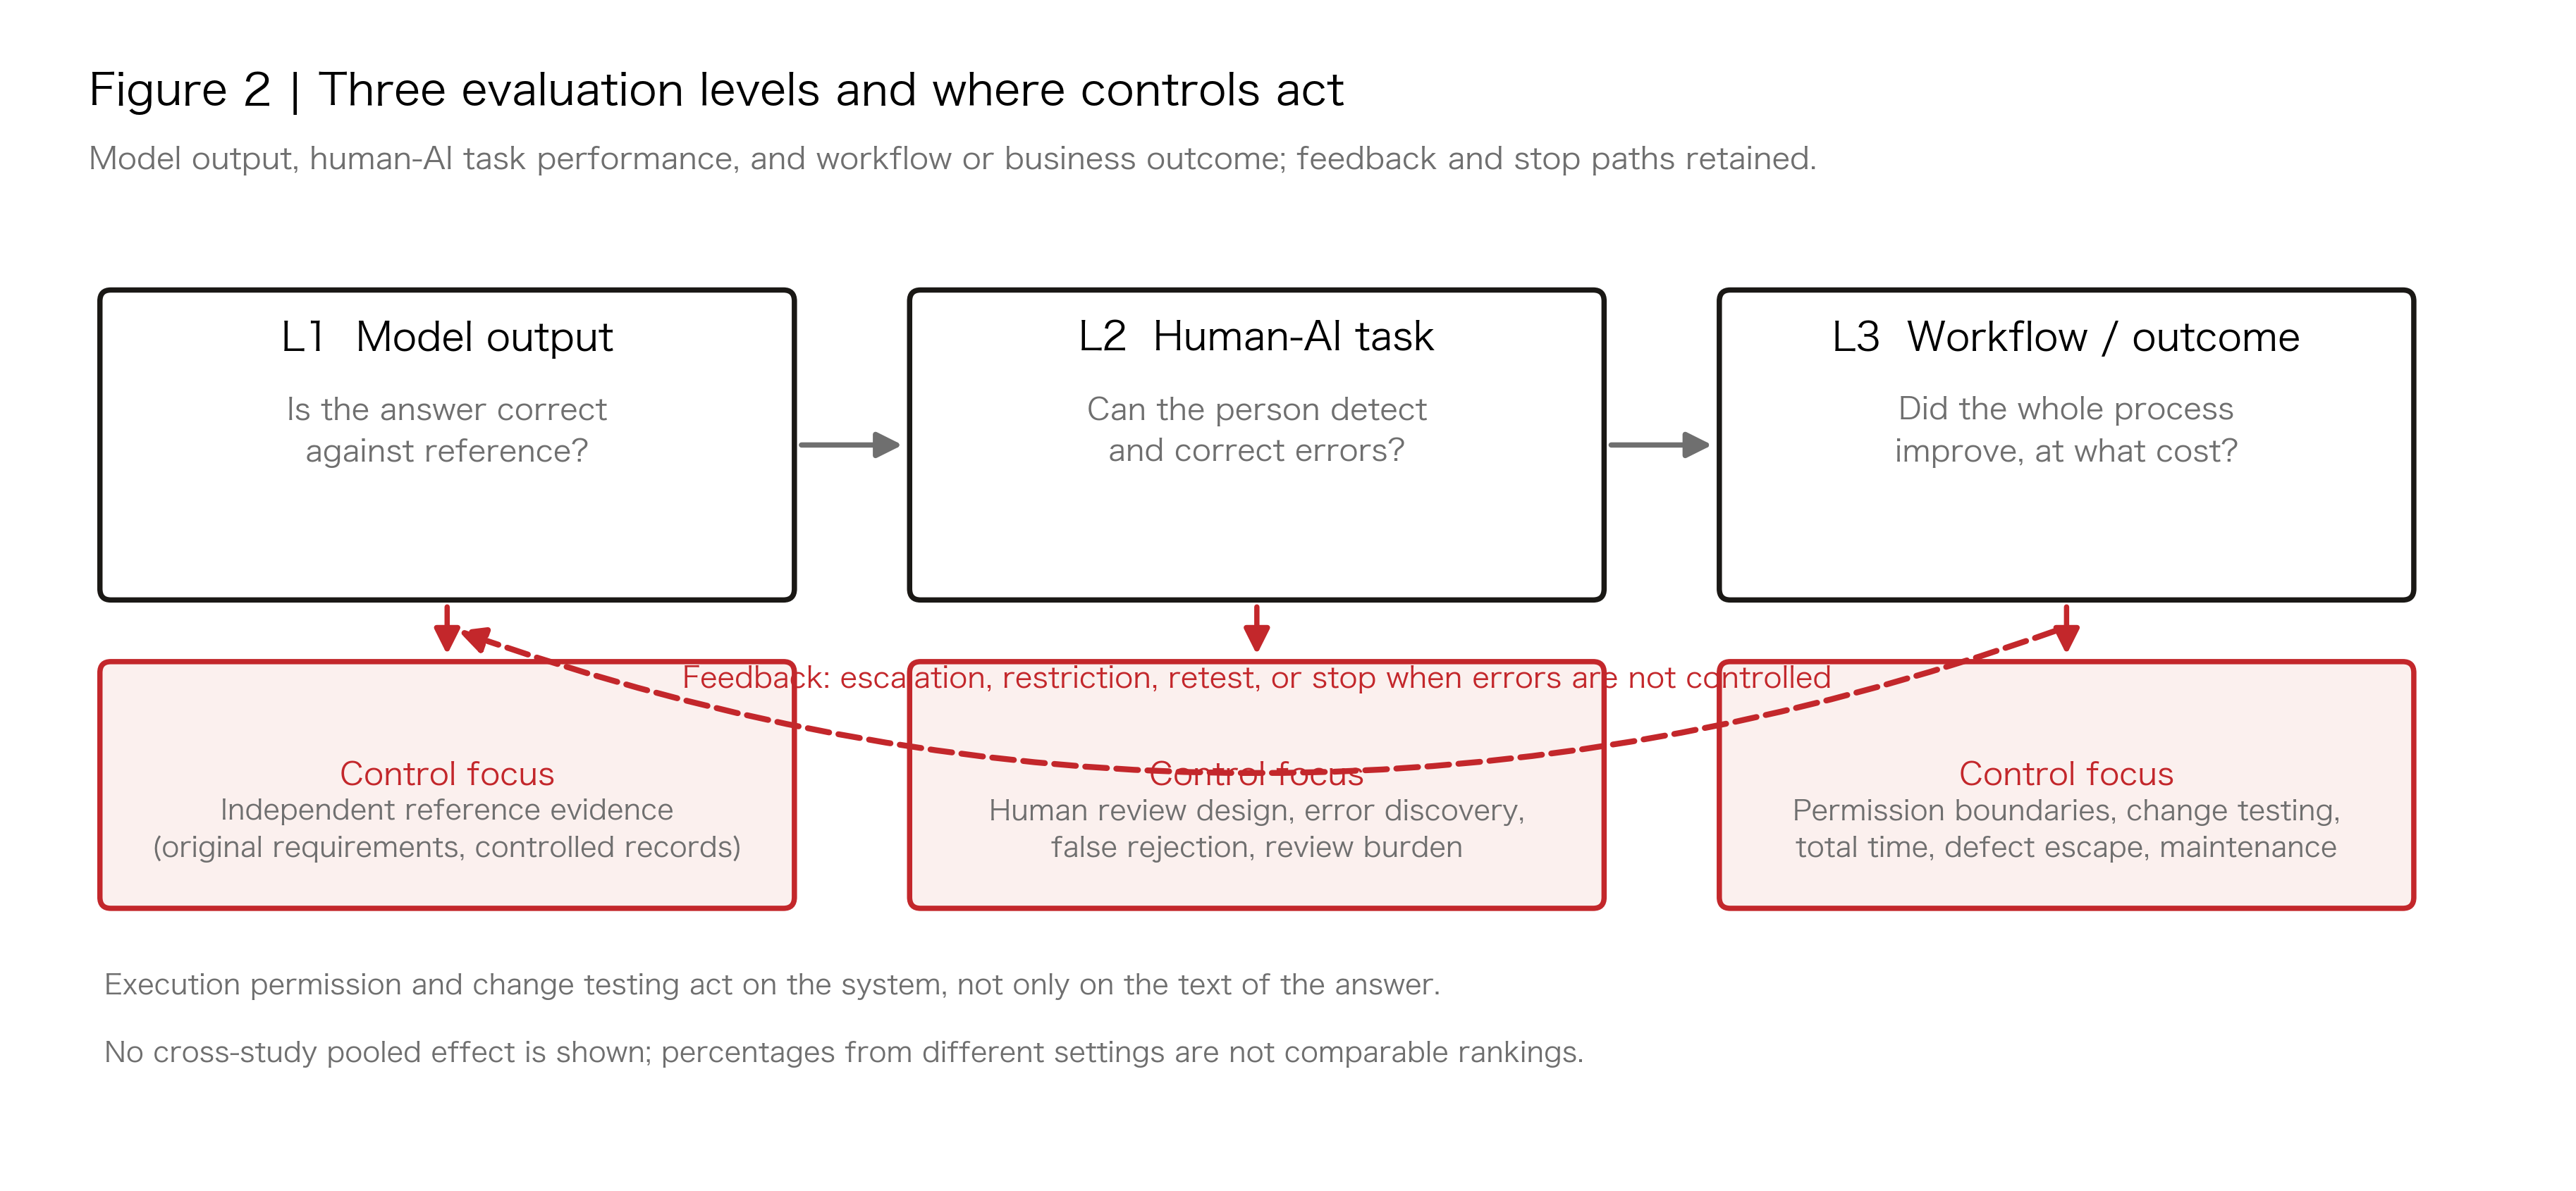
各证据最一致的提醒是:终点不可混用。模型答不答得对、人机组合做不做得完任务、业务结果改没改善,是三个层级。前一层进步,不自动带来后一层收益。2026 年一项基于 273 份利益相关方回复的调查,识别了药品生命周期 AI 的监管研究优先项;它说明需求仍在,证明不了任何具体控制已经有效。15
五、从模型评价转向完整工作流
作为交付对象,模型之外的依赖同样影响结果。检索增强生成(Retrieval-Augmented Generation,RAG)系统还依赖知识库、文档版本、检索规则和提示模板;能调用工具的智能体(AI Agent),又多出接口、权限和异常恢复。系统验证(Validation)要支持的是预定用途;单个输出的核验(Verification),只能回答这一次结果是否满足具体要求。
Rabanser 等评估了 15 个模型和两个任务基准,把智能体可靠性分成一致性、稳健性、可预测性和安全性。结论是:能力在涨,可靠性只跟着涨了一点。16 这个结果受模型、任务和评价架构限制;药品生产质量管理规范(Good Manufacturing Practice,GMP)场景还要建立自己的验收依据。这些研究维度可以用来出测试假设:同一任务重复跑,改动不影响实质的输入形式,加入工具故障,再看失效能不能被发现、能不能被限制住。
工作流评价还要覆盖停止和转交。系统缺少关键依据时,合适的行为可能是暂缓判断。拿偏差助手来说,比文字流畅度更有意义的终点是:关键事实遗漏、错误根因建议、过期资料采用、人工发现错误的比例,以及从开始处理到获准使用的总耗时。这些指标及其容许限度宜在正式评价前定下来;一边改系统,一边把同一批案例一直当独立测试用,它们就不再独立了。
真实动作要独立核对。智能体说"草稿已保存",不等于目标系统里真有那条正确记录。人工智能公司 Anthropic 的工程实践把执行轨迹(Execution Trace)和环境最终状态(Outcome)分开看。17 检查质量管理系统(Quality Management System,QMS)接口时可以照此核对:目标记录、字段、批准状态、重复写入。这是从厂商实践转译来的测试建议,效果还要在具体工作流里验证。
比较工具价值,要把审核和返工算进去。英国药品和健康产品管理局(Medicines and Healthcare products Regulatory Agency,MHRA)披露过一个案例:一份 AI 辅助的检查回复含重大不准确内容,审查与回应耗时从约 4 小时变成超过 20 小时。18 单个案例给不出一般发生率,却说明成本可能转移到下游。比较试点要同时记录初稿用时、复核用时、错误后果和维护成本,任务难度和人员经验尽量保持可比。
六、人在环需要证明的是监督效果
三个词先分清:人在环(Human-in-the-Loop,HITL)是把人工判断纳入流程;人类监督(Human Oversight)要求人员能理解、质疑、干预;人工复核(Human Review)是落实监督的一项具体活动。有没有效,看的是人能否发现并纠正错误。FDA 与欧洲药品管理局(European Medicines Agency,EMA)在 2026 年共同原则第 8 项中,把人机交互纳入完整系统的性能评价。19 该原则给了评价方向,没给出统一的人工复核效果值。
自动化偏差(Automation Bias)研究说明:经验丰富也不能消除对错误建议的依赖。13 但这不等于人工复核必然无效。界面、任务难度、时间压力、拒绝权限不同,监督表现可能不同。Goh 等的试验也排除不了专门训练或换交互设计后的收益。12
复核环节的试验可以这样做:一组只做末端确认,另一组提供原文、差异提示和明确的拒绝权限。挑战案例应包含真实工作中可能发生的错误引用、遗漏和错误建议;评价者手里要有预先确定的参考答案。主要看四个数:错误发现率、错误纠正率、正常输出被误拒的比例、复核负担。只看签名率、阅读时长或培训完成率,证明不了监督起效。
复核也可能产生代价。低价值提示过多会分散注意,重复核查可能延长周期,过宽的责任措辞可能导致形式性签字。更复杂的审核界面如果没减少严重遗漏、反而明显增加时间,就该调整措施。风险较低的用途可以用较轻的安排;高影响决定仍须符合适用质量体系的授权要求。
七、交叠情境中的证据独立性
AI 生成方案、生成测试题、再评价自己的答案,同一个错误会贯穿整条文件链。换个模型也未必解决:两个模型可能共享资料、训练偏差或错误前提。证据独立性(Evidence Independence)看的是判断依据和失效机制,不能只数参与者有几个。
假设一个情境:偏差助手升级。起草工具只检索到旧版规程,测试生成工具沿用同一批资料,评价工具再按同一标准判通过。三个环节可能一起漏掉新增要求。重跑多少次都只是重复这个遗漏;把当前受控规程引进来当独立参考,才能检验要求有没有覆盖。这个例子说明的是待测试的失效机制,不代表已经观察到的企业事件。
一种可检验的安排:参考答案、风险场景和通过条件,建立在原始要求、受控记录和适当专业判断上。AI 提出的案例可以进候选集,但覆盖范围和标签要另行核查。欧洲《附录 22:人工智能》(Annex 22: Artificial Intelligence)2025 年征询草案 §5.6 不推荐用生成式 AI 生成测试数据或标签,并要求对任何此类使用充分论证。20 这项特定草案表述,不能扩写成"所有 AI 辅助测试一律禁止"。
记不记、记多少,看这条输出有没有真的影响决定。一个输出如果改变调查范围或支持处置,界面上写"仅供参考"也消除不了它的证据作用。反过来,也不必把所有试探性对话无差别纳入正式质量记录。工程上可记录:任务用途、输入的受控位置、系统版本、实际采用的输出、支撑依据、审核判断和后续动作;具体保存范围和期限,由适用要求和企业制度确定。
这些安排还需要比较证据。试验要报告两件事:独立参考方案减少了多少未发现的严重错误,多付出了多少成本。新增文档数量只说明工作发生了,效果判断仍要看纠错结果。
八、智能体的执行权限必须在系统中落实
读资料、起草建议、写入正式系统,是三种不同的行动能力。所以自主程度要单独看、单独管——这和它是"对象"还是"工具"无关。一个身份只是"工具"的智能体,也可能握着足以影响质量记录的权限。
美国国家标准与技术研究院(National Institute of Standards and Technology,NIST)2026 年 9 月 15 日发布第 8587 号机构间报告(Interagency Report,IR)最终版,谈令牌与身份断言的伪造、盗取和滥用。§1.1.1 明确涵盖智能体通过签名令牌访问系统、数据、工具和接口的情形,同时限定它不是全面的智能体接入风险指南。21 这是一份通用安全文件,不能当作药品监管要求。NIST 下属的国家网络安全卓越中心(National Cybersecurity Center of Excellence,NCCoE)此前也把智能体身份、授权和审计列为研究议题。22
身份认证(Authentication)回答"谁在访问",授权(Authorization)决定"允许做什么"。提示注入(Prompt Injection)是把诱导指令夹进资料、让系统偏离任务;针对它,只在提示词里写"不要提交",构不成可靠的权限边界。访问控制要限定对象、动作和有效期,还要检验撤销访问后是否真停。§5.3.1.2 说明无状态架构中全局撤销未必即时生效,§5.3.1.3 和 §5.3.1.6 涉及权限范围与短期令牌。21
限制权限不是没有代价。过窄的授权可能阻断正常任务,促使人员绕过系统;日志过少不利于追查,过多则增加敏感信息暴露。测试要同时看两件事:越权行为受没受阻,获准任务做不做得完。按 §5.3.1.5 和 §5.3.1.7,审计日志(Audit Log)要防篡改,并避免记录令牌、断言本体及其中的个人数据。21
九、把监管边界和变更责任写入项目交付
同一项技术,监管要什么,往往看用途和适用对象。FDA/EMA 共同原则首页明确列出包括制造在内的药品生命周期;国家药品监督管理局(National Medical Products Administration,NMPA)的 2026 年实施意见直接面向药品监管体系,强调辅助定位和责任边界。19, 23 后者不能被读成"药企生产活动已获准自主决策"。
表 3|关键文件的状态与可迁移范围。状态截至 2026 年 9 月 20 日。
表 3|关键文件的状态与可迁移范围。状态截至 2026 年 9 月 20 日。
| 文件 | 已核查状态及范围 | 可用于项目判断的内容 | 不宜推导的结论 |
|---|---|---|---|
| FDA/EMA 良好 AI 实践原则19 | 2026 年共同原则;药品生命周期 | 使用情境、完整系统及生命周期评价 | 一套指标可覆盖全部用途 |
| FDA 药品 AI 可信度指南5 | 2025 年草案,非实施文件;支持监管决策的 AI | 把证据要求与具体用途及风险联系 | 全部办公 AI 均直接适用 |
| 欧盟附录 2220, 24 | 2025 年征询草案;EMA 年报仍记载意见处理及年内完成计划 | 模型范围、测试数据、变更重测等监管关注 | 征询关闭即生效;行业全面禁止语言模型 |
| FDA 预定变更控制计划指南25 | 2025 年最终指南;AI 医疗器械软件功能 | 预先规定变更、实施协议及影响评价 | 药品 GMP 豁免;计划范围内无需验证 |
| 国家药监局实施意见23 | 2026-03-11 成文,04-02 公开;药品监管体系 | 辅助定位、责任主体、验证评价 | 对企业自主生产决策的普遍授权 |
| NIST IR 858721 | 2026-09-15 最终版;通用身份与访问安全 | 令牌、授权、撤销与审计控制 | 完整的智能体安全认证或制药合规证明 |
附录 22 草案第 1 节聚焦关键 GMP 应用中的静态模型(Static Model)与确定性输出(Deterministic Output),提出动态模型(Dynamic Model)、生成式 AI 和大语言模型(Large Language Model,LLM)不应用于上述关键 GMP 应用;对非关键 GMP 的生成式用途,则提出由合格人员确认输出的安排。20 "动态"指运行中继续学习;静态模型的受控升级,不能一概归入动态模型。草案方向需要关注,正式适用状态要在实施时复查。
变更控制(Change Control)要覆盖实际改变行为的组件:模型、知识库、检索方式、提示模板、接口和权限。预定变更控制计划(Predetermined Change Control Plan,PCCP)的器械指南提供了一个预先规划变化的例子:按已授权计划规定的方法完成验证并满足条件,某些计划内变更可免于追加上市申报;这不免除测试,也不构成药品 GMP 的申报安排。25
项目交付要明确后续责任人。建设团队随模型移交批准配置、监测指标、变更评估和退出条件。质量或业务负责人要知道何时限制用途、转人工或停用;供应商变更通知、知识库失效、关键错误重复发生,都可能触发复评。附录 22 草案 §10.1 提出评估变更是否需要重测;决定不重测,要给出理由。20 具体测试负担仍应结合影响,避免所有细小变化都触发同样的完整重验。
十、差距分析:需要验证的是控制的增量价值
已有文献提出制药 AI 的综合治理框架。Patel 与 Patel 把验证、伦理和生命周期管理结合在一起,但其框架尚未经实证验证。26 所以,多画一张流程图、多加几层控制,本身不构成研究贡献。角色视角有没有用,要与既有风险管理和使用情境管理比较才知道。
表 4|从建议到可证伪的研究问题。以下为研究设计建议,尚无实施结果。
表 4|从建议到可证伪的研究问题。以下为研究设计建议,尚无实施结果。
| 关键缺口 | 比较设计 | 主要终点 | 会削弱建议的结果 |
|---|---|---|---|
| 角色框架是否增加价值 | 使用情境与风险评估,对比增加角色—责任映射的流程 | 严重责任遗漏、交接后未处理问题、准备时间 | 未减少遗漏,却持续增加管理负担 |
| 人工监督怎样有效 | 末端确认,对比提供原始依据、差异和拒绝权限的复核 | 严重错误发现与纠正、误拒、总耗时 | 纠错未改善,或收益被复核负担抵消 |
| 独立证据能否降低共同失效 | 同一 AI 自评,对比独立参考答案及专业审核 | 未发现的严重错误、测试覆盖、额外成本 | 效应区间排除了预先定义的最小有用改善,或增量改善不足以抵偿额外成本 |
| 权限控制能否兼顾安全与可用 | 提示词限制,对比系统强制权限;离线或沙箱实施 | 实际越权动作、正常任务完成率、恢复时间 | 越权仍发生,或合法工作大量被阻断 |
| 变更测试如何确定范围 | 全面回归,对比风险和影响驱动的测试安排 | 漏检的严重退化、测试工时、恢复能力 | 节省时间伴随不可接受的漏检增加 |
这些终点要预先定义。比如"责任遗漏",可记为预定质量相关决定中缺少指定责任人或必要证据要求的比例;"严重"按潜在质量或安全后果事先分级。漏检,可用已知错误集合中的未检出比例衡量;权限控制后的可用性,可用获准任务完成数占测试任务数的比例衡量。净工时包括准备、生成、复核、返工和分摊维护时间。错误参考标准宜由不参与系统调优的合格人员建立,对存在分歧的案例保留裁定记录。研究方案还要预先定下最小有用改善和可接受的成本或工时增幅,具体数值由任务后果与基线流程确定。
做效果比较,是为了优化控制设计;适用法规明确要求的控制,试验没测出净收益也照做。
这类研究要在安全的历史数据或沙箱里起步。单 AI 基线可用于离线比较,不代表授权其自主执行。样本要覆盖正常任务和重要失效,保留未用于调优的案例,并报告不确定性。有生产影响的研究,实际实施还须纳入现有质量体系控制。
当前判断有三项主要限制。第一,定向检索可能遗漏研究,公开程度也影响纳入;"尚不足以支持"不能写成"整个领域没有证据"。第二,多数较强的比较研究来自其他领域,迁移到制药任务要重新验证。第三,模型和法规都在变化,2023 年的人机实验与 2026 年的智能体不能视为同一种干预。角色框架、工程建议和控制组合的效果,都不因引用了新文件就算已经成立。
结论
对象、工具与交叠,有助于把证据责任问题问出来,但还不是经过验证的管理干预。制药项目采用 AI 的依据,要从具体用途出发,把模型表现、人工判断、实际动作和完整工作流结果连起来。现有证据支持审慎试验部分辅助任务,也暴露了成本向复核端转移、监督失效和共同错误的可能。能支持持续使用的,是在明确边界下反复取得的质量与收益证据,以及失效后可执行的限制、纠正和退出安排。
附录:中英术语与缩写速查
机构与学术会议
| 缩写或名称 | 中文名称 | 英文全称 | 阅读提示 |
|---|---|---|---|
| FDA | 美国食品药品监督管理局 | Food and Drug Administration | 警告信及相关药品、器械指南的发布机构 |
| PMI | 项目管理协会 | Project Management Institute | 项目管理专业标准的发布机构,不是药品监管机构 |
| EMA | 欧洲药品管理局 | European Medicines Agency | 参与药品监管与相关 AI 指导工作 |
| MHRA | 英国药品和健康产品管理局 | Medicines and Healthcare products Regulatory Agency | 检查回复案例的发布机构;Inspectorate 指其检查部门 |
| NMPA | 国家药品监督管理局,简称国家药监局 | National Medical Products Administration | “人工智能+药品监管”实施意见的发文机关 |
| NIST | 美国国家标准与技术研究院 | National Institute of Standards and Technology | 提供技术标准与安全建议,不是药品监管机构 |
| NCCoE | 美国国家网络安全卓越中心 | National Cybersecurity Center of Excellence | NIST 下属中心;此处涉及智能体身份与授权工作 |
| PIC/S | 药品检查合作计划 | Pharmaceutical Inspection Co-operation Scheme | 药品监管检查合作安排;见官方介绍 |
| European Commission | 欧洲联盟委员会,简称欧盟委员会 | European Commission | 附录 22 征询草案的官方发布渠道 |
| ICML | 国际机器学习大会 | International Conference on Machine Learning | 学术会议名称;论文被接收不等于药品监管批准 |
技术与质量管理缩写
| 缩写 | 中文名称 | 英文全称或写法 | 一句话理解 |
|---|---|---|---|
| AI | 人工智能 | Artificial Intelligence | 相关模型与系统技术的统称 |
| COU | 使用情境 | Context of Use | 模型在具体问题中承担什么作用,以及适用范围 |
| RAG | 检索增强生成 | Retrieval-Augmented Generation | 先检索资料,再利用资料生成回答;检索到资料不保证判断正确 |
| LLM | 大语言模型 | Large Language Model | 能处理与生成语言的模型,生成内容仍需核验 |
| GMP | 药品生产质量管理规范 | Good Manufacturing Practice | 药品生产和质量管理相关规范 |
| GxP / GXP | 相关质量规范的统称 | Good Practice(s),x 为领域占位符 | 涵盖生产、临床试验、实验室等不同活动的质量规范;并非一份独立标准 |
| HITL | 人在环 | Human-in-the-Loop | 将人工判断纳入流程,并使人员能够拒绝结果或中止执行 |
| QMS | 质量管理体系;作为软件时称质量管理系统 | Quality Management System | 可指组织的质量管理体系,也可指支持该体系的软件;正文写入场景指软件 |
| PCCP | 预定变更控制计划 | Predetermined Change Control Plan | 在器械指南所述范围内,预先说明变更及其验证、实施方法 |
| IR | 机构间报告 | Interagency Report | IR 8587 的报告系列标识;这里不是某个 AI 模型名称 |
| DOI | 数字对象标识符 | Digital Object Identifier | 用于识别和定位文献的持久标识,不表示文献结论已获认可 |
| MARCS-CMS | 任务履行与监管合规服务平台的合规管理系统(释义) | Mission Accomplishments and Regulatory Compliance Services — Compliance Management System | FDA 警告信页面的系统标识;722591 为个案编号,不是法规条款 |
MARCS 的展开见 FDA 原始报告,CMS 的展开见 FDA《监管程序手册》第 4 章。IR 8587 使用“机构间报告”这一名称;NIST 的系列总称还包括内部报告(Internal Report),见 NIST 系列释义。
项目管理与工程术语
| 中文术语 | 英文对应 | 一句话理解 |
|---|---|---|
| 对象身份、交付物 | AI as a Deliverable / Deliverable | 项目负责建成并交付的 AI 系统 |
| 工具身份 | AI as a Tool | 用 AI 辅助完成项目工作 |
| 交叠 | Overlap / Overlapping Roles | AI 工具参与 AI 项目管理,两种任务在同一工作情境中相遇 |
| 项目 | Project | 为形成独特结果而开展的临时工作 |
| 项目集 | Program | 协调管理相关项目及活动,以获得共同收益 |
| 项目组合 | Portfolio | 为实现战略目标而统筹管理的项目、项目集及其他工作 |
| 生命周期管理 | Lifecycle Management | 从开发、上线到运行、变更与退出的持续管理 |
| 全生命周期治理 | Lifecycle Governance | 在各阶段明确责任、决策权限与监督安排 |
| 预定用途 | Intended Use | 预先说明系统要做什么;使用情境进一步交代它在具体问题中的作用 |
| 风险评估 | Risk Assessment | 判断可能出错的地方、后果及所需控制 |
| 数据治理 | Data Governance | 管理数据来源、质量、权限、责任和使用条件 |
| 可信度评估 | Credibility Assessment | 用证据判断模型在特定使用情境中是否值得依赖 |
| 验证 | Validation | 在此制药语境中,以证据支持系统或过程适合其预定用途 |
| 工艺验证 | Process Validation | 针对生产工艺建立并持续维持适用性与稳定表现的证据 |
| 核验、核查 | Verification | 检查具体要求或事实是否得到满足;不与验证机械互换 |
| 验收准则 | Acceptance Criteria | 正式测试前确定的通过条件 |
| 变更控制 | Change Control | 对变更进行评估、批准、实施与记录的受控安排 |
| 变更管理 | Change Management | 围绕变化组织计划与实施;具体技术变更仍需相应控制 |
| 人工复核 | Human Review | 人检查具体输出、依据及适用性,是实现监督的一项活动 |
| 人类监督 | Human Oversight | 人能够理解、质疑、干预并承担相应责任 |
| 人机交互 | Human–AI Interaction | 人与 AI 在同一任务中的信息交换和操作配合 |
| 智能体 | AI Agent | 能围绕任务调用工具并连续执行的 AI 系统 |
| 生成式人工智能 | Generative AI | 生成文本等内容的 AI;不一定具备自主执行能力 |
| 静态模型 | Static Model | 在所讨论的运行状态中,训练结束后不继续学习的模型 |
| 动态模型 | Dynamic Model | 在运行中继续学习,并据此改变自身行为的模型;静态模型的受控版本升级不因此一概属于动态模型 |
| 确定性输出 | Deterministic Output | 在相同输入和相同系统条件下,得到相同输出 |
| 智能体可靠性 | Agent Reliability | 系统能否稳定完成任务,并以可识别、可控制的方式失败 |
| 一致性 | Consistency | 同一任务重复运行时,表现是否稳定 |
| 稳健性、鲁棒性 | Robustness | 面对输入变化或工具异常时,表现是否仍可接受 |
| 可预测性 | Predictability | 失败能否被预判;提供的置信表达是否与实际表现相符 |
| 安全性 | Safety | 错误造成的损害是否受到控制,区别于下列访问安全含义 |
| 信息与网络安全 | Information Security / Cybersecurity | 防止未经授权的访问、攻击和数据泄露等风险 |
| 执行轨迹 | Execution Trace / Trajectory | 系统执行时的输出、工具调用和中间结果记录 |
| 环境最终状态、实际结果 | Outcome | 任务结束后目标系统中实际发生的结果 |
| 身份与访问控制 | Identity and Access Control | 确认访问主体,并限制其可以执行的操作 |
| 身份认证 | Authentication | 确认访问者是谁 |
| 授权 | Authorization | 决定该访问者能做什么 |
| 访问令牌 | Access Token | 用于获得受限访问权限的凭据;不应直接写入日志 |
| 身份断言 | Identity Assertion | 关于主体身份及相关属性的声明,可用于身份流程 |
| 审计日志 | Audit Log | 供检查和追溯使用的操作、事件记录 |
| 提示注入 | Prompt Injection | 将恶意指令夹入系统处理的内容,诱导其偏离授权任务 |
| 评估 | Evaluations;简称 Evals | 用任务、标准和检查方法判断系统表现 |
标准名称、专名与书目读法
| 名称或标记 | 中英对照与说明 |
|---|---|
| PMI AI 标准 | 《项目组合、项目集与项目管理人工智能标准》/The Standard for Artificial Intelligence in Portfolio, Program, and Project Management |
| Annex 22 | 《附录 22:人工智能》/Annex 22: Artificial Intelligence;Annex 意为“附录” |
| § | 条款或节的标记(Section);§5.6 即第 5.6 条或节,按原文件结构理解 |
| Anthropic | 人工智能公司名称,保留专名,不另造英文全称 |
| Purolea Cosmetics Lab | 警告信涉及的企业名称,保留原名;其检查对象为药品生产场所 |
| arXiv | 论文预印本平台专名,不是需要展开的缩写;v3 中的 v 表示 Version,即第 3 版 |
| Clinical Pharmacology & Therapeutics | 《临床药理学与治疗学》,期刊名称 |
| 作者姓名中的首字母 | 如 Rabanser, S.:姓氏加名字首字母,为书目记法;“等”表示另有合著者 |
标准和文献的中文译名用于辅助阅读,英文原名及所附链接用于准确回查。
研究方法、统计与新增专名
| 名称或缩写 | 中文名称 | 英文对应 | 阅读提示 |
|---|---|---|---|
| SANRA | 叙述综述质量评估量表 | Scale for the Assessment of Narrative Review Articles | 检查叙述综述质量的工具,不是系统综述报告规范 |
| CI | 置信区间 | Confidence Interval | 反映估计的不确定性;正文直接写中文 |
| OR | 比值比 | Odds Ratio | 不能当作风险比;正文直接写中文 |
| Hedges’ g | 经小样本校正的标准化均值差 | Hedges’ g | 用于跨研究比较;正负方向取决于对照定义 |
| BI-RADS | 乳腺影像报告与数据系统 | Breast Imaging Reporting and Data System | 出现在乳腺影像研究题名中,并非制药评级 |
| JAMA | 美国医学会杂志品牌 | Journal of the American Medical Association | JAMA Network Open 是其期刊系列成员,题名保留官方品牌 |
| Critical Narrative Review | 批判性叙述综述 | Critical Narrative Review | 比较证据与解释的综述方式,不声称穷尽检索 |
| Evidence Accountability | 证据责任 | Evidence Accountability | 谁提供、审查及据以作出决定的责任 |
| Evidence Independence | 证据独立性 | Evidence Independence | 判断依据和失效机制具有足够独立性,而非仅换一个评价模型 |
| Common-Cause Failure | 共同失效、共因失效 | Common-Cause Failure | 多个环节因共享原因而同时出错 |
| Automation Bias | 自动化偏差 | Automation Bias | 人因依赖自动化建议而偏离适当判断 |
| Human–AI Collaboration | 人机协作 | Human–AI Collaboration | 人与 AI 共同完成任务;是否优于各自完成需要比较 |
| Systematic Review / Meta-analysis | 系统综述/元分析 | Systematic Review / Meta-analysis | 前者强调系统检索与评价,后者对可合并结果作定量综合 |
| Randomized Clinical Trial | 随机临床试验 | Randomized Clinical Trial | 通过随机分配比较干预;未必直接评价真实患者结局 |
| Pragmatic Cluster-Randomized Trial | 实用性整群随机试验 | Pragmatic Cluster-Randomized Trial | 在较接近实际工作的条件下按群组随机分配 |
| Sandbox | 沙箱 | Sandbox | 与正式生产隔离的受控测试环境 |
| Regression Testing | 回归测试 | Regression Testing | 变更后检查既有行为是否发生不可接受的退化 |
| Gradient Boosting | 梯度提升 | Gradient Boosting | 逐步组合较弱预测模型的方法,不等同于生成式语言模型 |
| Science | 《科学》 | Science | 期刊名称 |
| The Quarterly Journal of Economics | 《经济学季刊》 | The Quarterly Journal of Economics | 期刊名称 |
| Quasi-experiment | 准实验 | Quasi-experiment | 利用非随机变化进行效果比较,仍需审查识别假设 |
| Difference-in-differences | 双重差分、差分比较 | Difference-in-differences | 比较不同组在干预前后的变化差异,依赖相应识别假设 |
| Nature Human Behaviour | 《自然·人类行为》 | Nature Human Behaviour | 期刊名称 |
| Nature Medicine | 《自然·医学》 | Nature Medicine | 期刊名称 |
| JAMA Network Open | 《美国医学会杂志网络开放版》 | JAMA Network Open | 期刊名称,中文为辅助译名 |
| Radiology | 《放射学》 | Radiology | 期刊名称 |
| International Journal of Pharmaceutics | 《国际药剂学杂志》 | International Journal of Pharmaceutics | 期刊名称 |
| Journal on Artificial Intelligence | 《人工智能期刊》 | Journal on Artificial Intelligence | 期刊名称,中文为辅助译名 |
| AI and Ethics | 《人工智能与伦理》 | AI and Ethics | 期刊名称 |
| Research Integrity and Peer Review | 《科研诚信与同行评议》 | Research Integrity and Peer Review | 期刊名称 |
参考文献
- 美国食品药品监督管理局(FDA). 《致 Purolea Cosmetics Lab 的警告信》(Purolea Cosmetics Lab — MARCS-CMS 722591). 2026-04-02。监管警告信;具体药品生产场所个案。 原始出处
- 项目管理协会(PMI). 《PMI 发布全球首个项目工作 AI 标准》(PMI Publishes World's First Global Standard for AI in Project Work). 2026-06-09。官方发布公告;仅据公开说明,不作标准全文逐条解释。 原始出处
- 项目管理协会(PMI). 《项目组合、项目集与项目管理人工智能标准》(The Standard for Artificial Intelligence in Portfolio, Program, and Project Management). 2026-06。官方标准介绍页。 原始出处
- Baethge, C., Goldbeck-Wood, S., & Mertens, S. 《SANRA:叙述综述文章质量评估量表》(SANRA—a Scale for the Quality Assessment of Narrative Review Articles). Research Integrity and Peer Review,2019,4:5。DOI:10.1186/s41073-019-0064-8。方法学研究。 原始出处
- 美国食品药品监督管理局(FDA). 《使用人工智能支持药品和生物制品监管决策的考量》(Considerations for the Use of Artificial Intelligence to Support Regulatory Decision-Making for Drug and Biological Products). 2025-01。草案,非实施文件。 原始出处
- Salami, H., Smith-Goettler, B., & Yadav, V. 《语言模型如何协助制药制造偏差与调查?》(How Can Language Models Assist with Pharmaceuticals Manufacturing Deviations and Investigations?). International Journal of Pharmaceutics,2025,669:125100;2024-12-18 首次发表。DOI:10.1016/j.ijpharm.2024.125100。正式论文,仅取得摘要与出版社预览;不是独立于[7]的第二项研究。 原始出处
- Salami, H., Smith-Goettler, B., & Yadav, V. 《基础大语言模型能否协助制药制造调查?》(Can Foundational Large Language Models Assist with Conducting Pharmaceuticals Manufacturing Investigations?). arXiv:2404.15578,2024-04-24。早期预印本全文;20 例设计及评价细节仅据此版本。 原始出处
- Amin, M. 《通过人在环 AI 建立无纸化 GMP 验证的监管信心》(Building Regulatory Confidence with Human-in-the-Loop AI in Paperless GMP Validation). Journal on Artificial Intelligence,2026,8(1):1–18。DOI:10.32604/jai.2026.073895。沙箱试点,数据和评价报告存在限制。 原始出处
- Noy, S., & Zhang, W. 《生成式人工智能生产率效应的实验证据》(Experimental Evidence on the Productivity Effects of Generative Artificial Intelligence). Science,2023,381(6654):187–192。DOI:10.1126/science.adh2586。预注册随机实验。 原始出处
- Brynjolfsson, E., Li, D., & Raymond, L. 《工作中的生成式人工智能》(Generative AI at Work). The Quarterly Journal of Economics,2025,140(2):889–942。DOI:10.1093/qje/qjae044。正式版,分阶段上线的准实验分析。 原始出处
- Vaccaro, M., Almaatouq, A., & Malone, T. 《人类与 AI 的组合何时有效:系统综述与元分析》(When Combinations of Humans and AI Are Useful: A Systematic Review and Meta-analysis). Nature Human Behaviour,2024,8:2293–2303。DOI:10.1038/s41562-024-02024-1。 原始出处
- Goh, E. 等. 《大语言模型对诊断推理的影响:随机临床试验》(Large Language Model Influence on Diagnostic Reasoning: A Randomized Clinical Trial). JAMA Network Open,2024,7(10):e2440969。DOI:10.1001/jamanetworkopen.2024.40969。 原始出处
- Dratsch, T. 等. 《乳腺影像中的自动化偏差:人工智能 BI-RADS 建议对阅片表现的影响》(Automation Bias in Mammography: The Impact of Artificial Intelligence BI-RADS Suggestions on Reader Performance). Radiology,2023,307(4):e222176。DOI:10.1148/radiol.222176。 原始出处
- Agweyu, A. 等. 《生成式 AI 支持的基层医疗临床决策系统:实用性整群随机试验》(Generative AI-enabled Clinical Decision Support System in Primary Care: A Pragmatic, Cluster-Randomized Trial). Nature Medicine,2026,32:3032–3039;2026-06-26 发表。DOI:10.1038/s41591-026-04503-6。 原始出处
- Pinheiro, L. C. 等. 《药品生命周期 AI 应用的监管研究优先项:具有全球参考意义的欧洲视角》(Regulatory Research Priorities for AI Use in the Medicine Lifecycle: A European Perspective with Global Relevance). 《临床药理学与治疗学》(Clinical Pharmacology & Therapeutics). 首次发表 2026-08-13。数字对象标识符(DOI):10.1002/cpt.70400。 原始出处
- Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. 《迈向 AI 智能体可靠性的科学研究》(Towards a Science of AI Agent Reliability). arXiv:2602.16666v3,2026-06-02;页面注明国际机器学习大会(ICML)2026 接收。原始研究,非制药验证试验。 原始出处
- Anthropic(人工智能公司). 《理解 AI 智能体评估》(Demystifying Evals for AI Agents). 2026-01-09。厂商公开工程实践,非独立行业验证。 原始出处
- Brown, P./英国药品和健康产品管理局检查部门(MHRA Inspectorate). 《将 AI 用于 GxP 检查回复:设定标准而不抑制创新》(Use of AI for GXP Inspection Responses: Setting Standards Without Stifling Innovation). 2026-06-29。检查员官方说明,适用于所述检查回复场景。 原始出处
- 美国食品药品监督管理局(FDA)/欧洲药品管理局(EMA). 《药物开发良好 AI 实践指导原则》(Guiding Principles of Good AI Practice in Drug Development). 2026-01-14。共同指导原则。 原始出处
- 欧盟委员会(European Commission)/欧洲药品管理局(EMA)/药品检查合作计划(PIC/S). 《附录 22:人工智能》(Annex 22: Artificial Intelligence). 2025 年征询草案。涉及第 1 节、§5.6、§10.1。 原始出处
- 美国国家标准与技术研究院(NIST). 《保护令牌与断言免受伪造、盗取和滥用:面向政府机构及云服务提供商的实施建议》(Protecting Tokens and Assertions from Forgery, Theft, and Misuse: Implementation Recommendations for Agencies and Cloud Service Providers). NIST IR 8587,最终版,2026-09-15。通用身份与访问安全建议。 原始出处
- 美国国家标准与技术研究院(NIST)/美国国家网络安全卓越中心(NCCoE). 《关于软件智能体身份与权限的新概念文件》(New Concept Paper on Identity and Authority of Software Agents). 2026-02-05。概念文件与研究项目说明,非制药监管规范。 原始出处
- 国家药品监督管理局(NMPA). 《关于“人工智能+药品监管”的实施意见》(Implementation Opinions on “Artificial Intelligence + Drug Regulation”,英文为辅助译名). 国药监综〔2026〕6号;2026-03-11 成文,2026-04-02 公开。国家药监局信息中心所载原文。 原始出处
- 欧洲药品管理局(EMA). 《2025 年度活动报告》(Annual Activity Report 2025). EMA/148216/2026,2026-06-25,第 27 页。说明相关指南意见审阅与计划进度。 原始出处
- 美国食品药品监督管理局(FDA). 《采用人工智能的医疗器械软件功能预定变更控制计划:上市申报建议》(Marketing Submission Recommendations for a Predetermined Change Control Plan for Artificial Intelligence-Enabled Device Software Functions). 最终指南,2025-08-18(初版 2024-12-04)。适用于所述医疗器械软件功能。 原始出处
- Patel, B., & Patel, J. 《相关质量规范应用中 AI 与机器学习的验证、伦理及生命周期治理:比较监管分析与综合框架》(Validation, Ethics, and Lifecycle Governance of AI and Machine Learning in GxP Applications: A Comparative Regulatory Analysis and Integrated Framework). AI and Ethics,2026,6:363。DOI:10.1007/s43681-026-01218-9。概念性监管分析,非框架效果验证。 原始出处